
我们想更严格地回答一个看似简单的问题:究竟哪款小语言模型,真正适合在手机本地驱动一个有用的 Agent?
首轮对比覆盖了五个紧凑型 GGUF 模型。这次我们又加入五个候选:Llama 3.2 1B 和 3B、SmolLM2 1.7B 和 SmolLM3 3B,以及 LFM2.5 1.2B。完整实验由 10 个模型、20 组上下文配置、60 次成功的 iPhone 独立启动和 1,920 次确定性路由评测组成。
资源测试全部运行在 iPhone 15 Pro Max 真机上。所有模型统一使用 GGUF Q4_K_M、Metal 全层卸载,并分别测试 4K 和 8K context。能力测试则使用同一套 96 条中英文 Agent 请求,覆盖结构化解析、Skill 与 Action 选择、Mode 分类、缺槽识别和规划判断。
这不是一张泛化排行榜。我们关心的是:模型能否装进手机、能否快速响应,以及能否为可能触达提醒、邮件草稿或记忆的 Agent 稳定地产生结构化决策。
本轮测试的 10 个模型
左右滑动查看全部列
| 模型 | 发布方 | GGUF 大小 | 量化 |
|---|---|---|---|
| MiniCPM5-1B | OpenBMB | 656.2 MiB | Q4_K_M |
| LFM2.5-1.2B-Instruct | Liquid AI | 697.0 MiB | Q4_K_M |
| Llama 3.2 1B Instruct | Meta | 770.3 MiB | Q4_K_M |
| Gemma 3 1B IT | 768.7 MiB | Q4_K_M | |
| SmolLM2-1.7B-Instruct | Hugging Face | 1006.7 MiB | Q4_K_M |
| Qwen3.5-2B | Qwen | 1221.5 MiB | Q4_K_M |
| SmolLM3-3B | Hugging Face | 1826.6 MiB | Q4_K_M |
| Llama 3.2 3B Instruct | Meta | 1925.8 MiB | Q4_K_M |
| Qwen2.5-3B-Instruct | Qwen | 2007.4 MiB | Q4_K_M |
| Phi-4-mini 3.8B | Microsoft | 2376.4 MiB | Q4_K_M |
为了保证可复现,五个新增权重都固定了仓库 commit、SHA-256、许可证和 prompt profile。Llama 3 使用 header-token 模板,SmolLM3 显式加入 /no_think,LFM2.5 则使用要求的 start-of-text token。
为什么主线已经到 Qwen3.8,我们仍然测试 Qwen3.5?
Qwen 最新主线确实已经超过 3.5,但公开重点是体量大得多的云端和工作站模型。它们和需要常驻 8 GB 手机的 1B-4B 模型并不属于同一部署档位。
我们的目标需要可用的 8K 容量、受控的活跃 Prompt、可预测的内存,以及稳定的结构化输出。在这些约束下,Qwen3.5-2B 仍是很有代表性的手机尺寸候选。Qwen3.6、Qwen3.7 和 Qwen3.8 目前还没有一个明确的官方开放 1B/2B 级替代型号,能够承担完全相同的角色。
测试协议
左右滑动查看完整图表
图表暂时无法生成,下方仍可查看源代码。
查看图表源代码
flowchart LR
    A[固定模型 commit 与 SHA-256] --> B[应用原生 Prompt Profile]
    B --> C[iPhone 分别运行 4K 与 8K]
    C --> D[记录 Load TTFT 进程与 Metal 内存]
    D --> E[运行同一套 96 条双语路由用例]
    E --> F[应用资源与能力门槛]
真机为 iPhone 15 Pro Max,A17 Pro,8 GB 物理内存,iOS 26.6.1,SwiftLlama 和 llama.cpp b8668。每个模型与 context 组合独立启动三次,60 次运行全部成功加载。
真机使用短 prompt,因此数据衡量的是模型加载、context 分配、短提示 TTFT、基础生成和内存足迹,并不等于填满 4K/8K 的长 prefill 压测。96 例能力集使用相同模型文件和确定性参数,在桌面 Metal evaluator 上执行,以保证模型间对比可复现。
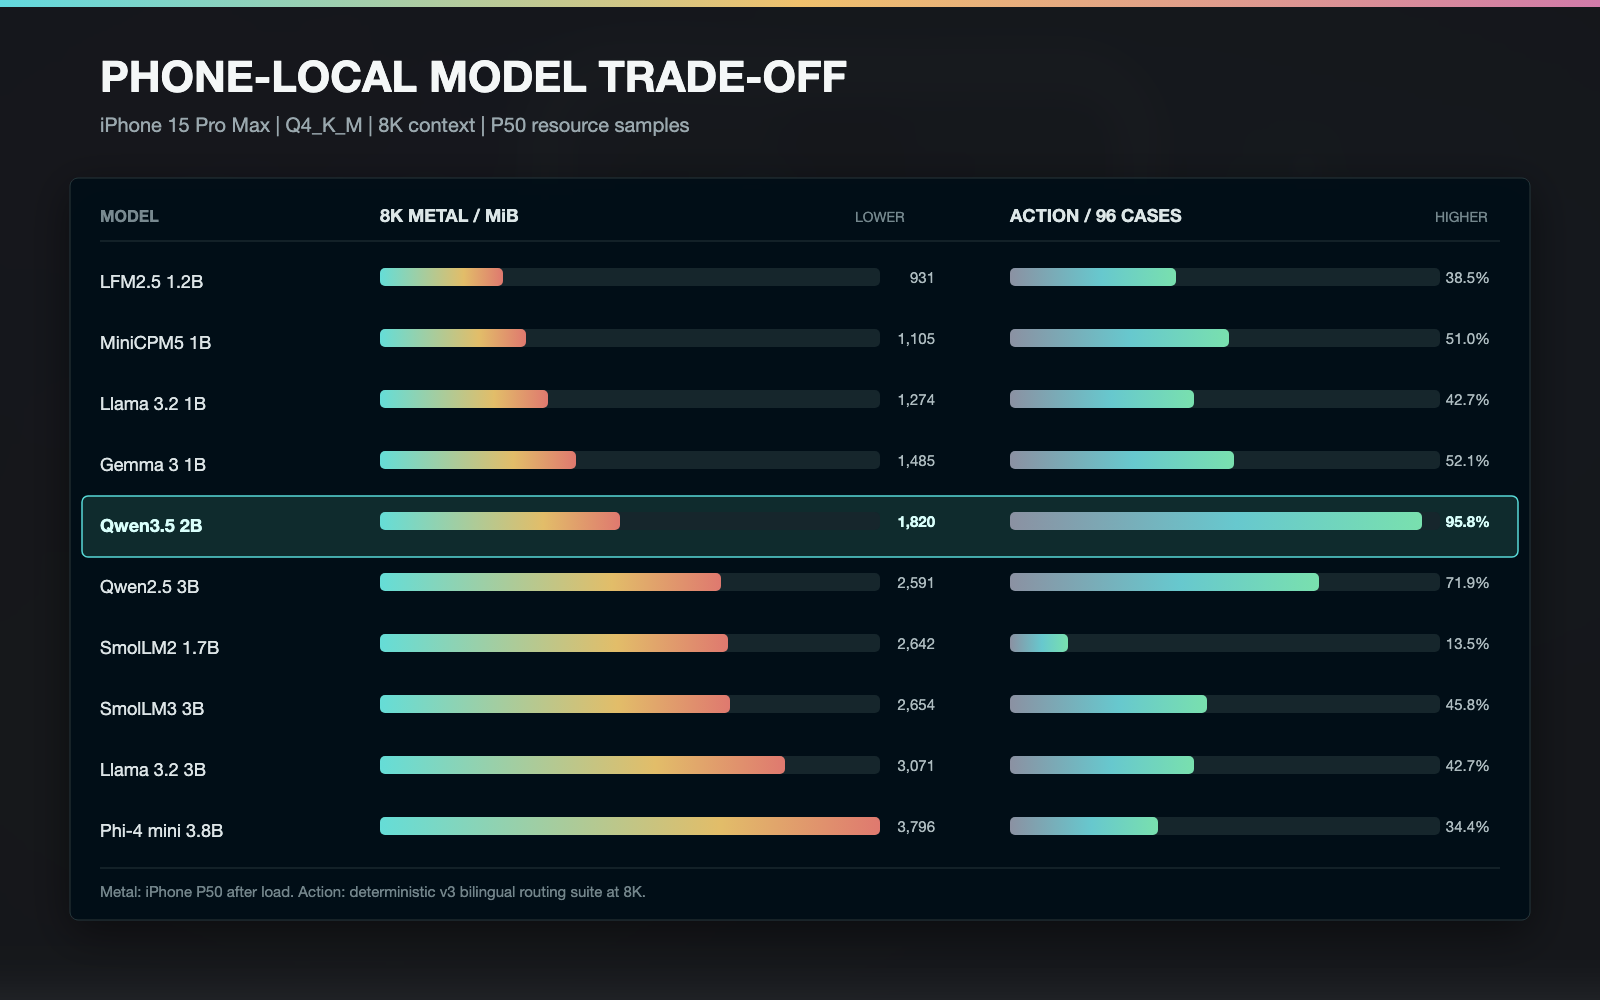
iPhone 15 Pro Max 的 4K/8K 资源结果
以下均为三次独立启动的 P50;成对数值依次为 4K / 8K。
左右滑动查看全部列
| 模型 | Load | TTFT | 进程内存 | Metal 内存 | Thermal |
|---|---|---|---|---|---|
| MiniCPM5-1B | 0.172 / 0.176 s | 0.140 / 0.136 s | 175.7 / 271.6 MiB | 1008.8 / 1104.8 MiB | Fair |
| Gemma 3 1B IT | 0.621 / 0.567 s | 0.215 / 0.200 s | 197.3 / 301.3 MiB | 1381.2 / 1485.2 MiB | Nominal |
| LFM2.5-1.2B | 0.132 / 0.131 s | 0.188 / 0.181 s | 110.5 / 158.2 MiB | 899.4 / 931.4 MiB | Nominal |
| Llama 3.2 1B | 0.228 / 0.237 s | 0.164 / 0.167 s | 228.8 / 356.8 MiB | 1145.8 / 1273.8 MiB | Fair |
| SmolLM2-1.7B | 0.188 / 0.253 s | 0.265 / 0.257 s | 823.4 / 1591.9 MiB | 1873.5 / 2641.5 MiB | Fair |
| Qwen3.5-2B | 0.323 / 0.323 s | 0.268 / 0.274 s | 201.4 / 249.6 MiB | 1767.8 / 1819.8 MiB | Fair |
| Qwen2.5-3B | 0.303 / 0.296 s | 0.445 / 0.442 s | 230.8 / 375.0 MiB | 2447.0 / 2591.0 MiB | Fair |
| Llama 3.2 3B | 0.319 / 0.374 s | 0.429 / 0.435 s | 550.2 / 999.0 MiB | 2623.3 / 3071.3 MiB | Serious |
| SmolLM3-3B | 0.293 / 0.314 s | 0.435 / 0.433 s | 390.8 / 679.2 MiB | 2366.1 / 2654.1 MiB | Nominal / Fair |
| Phi-4-mini 3.8B | 0.431 / 0.569 s | 0.503 / 0.511 s | 614.0 / 1126.4 MiB | 3291.8 / 3795.8 MiB | Nominal |
LFM2.5 是资源表现最好的模型,8K Metal 分配只有 931.4 MiB。Qwen3.5-2B 从 4K 升到 8K 只增加 52 MiB Metal 内存。SmolLM2 增加了 768 MiB;Llama 3.2 3B 则在六次真机样本中全部触及 Serious 热状态。
当 Prompt 真的接近装满
上面的 0.274 秒是 85-token 短 Prompt 的 TTFT,不能理解成 8K 内容也能在 0.274 秒内处理完。为此,我们又对最终候选 Qwen3.5-2B 做了近满窗口测试。
App 在模型加载后使用它自己的 tokenizer,把渲染后的 Prompt 精确校准为 3,584 和 7,680 tokens,各自为输出保留 512 tokens。每档独立启动三次、交错运行、轮次间冷却 30 秒,并在 prefill 后生成 63 tokens。下表为 P50,时间来自 llama.cpp 原生性能计数。
左右滑动查看全部列
| Context | 实际 Prompt | Prefill | Prefill 速度 | TTFT | 63-token 总耗时 | Decode | 生成后 Metal | Thermal |
|---|---|---|---|---|---|---|---|---|
| 4K | 3,584 tokens | 13.375s | 268.0 tok/s | 13.385s | 16.570s | 19.9 tok/s | 1769.4 MiB | Fair 1 / Serious 2 |
| 8K | 7,680 tokens | 30.583s | 251.1 tok/s | 30.602s | 33.868s | 19.7 tok/s | 1821.4 MiB | Serious 3 |
这里要把两个成本分开看。打开 8K 容量很便宜:静态 Metal 只比 4K 多 52 MiB,模型文件也不会变大。把 8K 真正填到 7,680 tokens 则不便宜:P50 prefill 是 3,584 tokens 的 2.29 倍,而且三次测试结束时都进入 Serious 热状态。
因此,8 GB 设备可以默认开放 8K context 上限,但 Runtime 不应该每轮都把历史、检索结果和 Tool 输出塞满。正常活跃 Prompt 应尽量保持在 2K-4K,只有任务确实需要时才扩展到 8K。
第二轮的完整协议、耗时范围、热状态分析和最终 Runtime 策略,详见《选定 Qwen3.5-2B 之后:4K 与 8K 在 iPhone 上的真实代价》。
96 例 Agent 能力测试
数据集包含 48 条中文和 48 条英文请求,覆盖 12 个 Skill,core 与 challenge 各占一半。Parse 表示完整两阶段协议成功,所有指标都按完整 96 例计分。成对数值依次为 4K / 8K。
左右滑动查看全部列
| 模型 | Parse | Skill | Action | Mode | 4K E2E P50 |
|---|---|---|---|---|---|
| MiniCPM5-1B | 62.5 / 62.5% | 85.4 / 85.4% | 51.0 / 51.0% | 53.1 / 53.1% | 0.622 s |
| Gemma 3 1B IT | 68.8 / 68.8% | 82.3 / 82.3% | 52.1 / 52.1% | 58.3 / 58.3% | 0.976 s |
| LFM2.5-1.2B | 56.2 / 56.2% | 80.2 / 80.2% | 38.5 / 38.5% | 44.8 / 44.8% | 0.903 s |
| Llama 3.2 1B | 53.1 / 53.1% | 86.5 / 86.5% | 42.7 / 42.7% | 46.9 / 46.9% | 1.401 s |
| SmolLM2-1.7B | 69.8 / 69.8% | 21.9 / 21.9% | 13.5 / 13.5% | 31.2 / 31.2% | 2.319 s |
| Qwen3.5-2B | 100 / 100% | 95.8 / 95.8% | 95.8 / 95.8% | 96.9 / 96.9% | 1.098 s |
| Qwen2.5-3B | 94.8 / 94.8% | 80.2 / 80.2% | 71.9 / 71.9% | 79.2 / 79.2% | 1.633 s |
| Llama 3.2 3B | 94.8 / 94.8% | 51.0 / 51.0% | 42.7 / 42.7% | 61.5 / 61.5% | 1.644 s |
| SmolLM3-3B | 76.0 / 76.0% | 56.2 / 56.2% | 45.8 / 45.8% | 49.0 / 49.0% | 2.015 s |
| Phi-4-mini 3.8B | 67.7 / 63.5% | 50.0 / 55.2% | 42.7 / 34.4% | 51.0 / 42.7% | 2.220 s |
新增候选在 8K 下没有自动变得更准,因为这些短路由请求本来就能轻松放进 4K。这里的 8K 测试验证的是部署成本与容量兼容性,而不是凭空增加智能。
新增模型带来了什么结论
LFM2.5-1.2B 是最强的新增资源候选。 它在真机上最轻,并达到 80.2% Skill 准确率;但 38.5% Action 准确率不足以安全驱动完整执行。它值得作为低风险第一阶段 Skill 粗选模型继续研究。
Llama 3.2 1B 的新增模型 Skill 得分最高,为 86.5%。 但 53.1% Parse 和 42.7% Action 暴露了清晰边界:识别意图比生成完整执行契约容易得多。它同样只适合 Skill-only 研究,并需要单独做许可证评估。
Llama 3.2 3B 能输出有效结构,但经常选错语义。 Parse 达到 94.8%,Skill 却只有 51.0%。它在 8K 下占用 3071.3 MiB Metal 内存,并反复进入 Serious 热状态。
SmolLM2-1.7B 不适合当前双语路由任务。 Skill 21.9%、Action 13.5% 均为最低,8K context 成本也异常高。
SmolLM3-3B 相比 SmolLM2 提升明显, 但 56.2% Skill 和 45.8% Action 仍未达到执行门槛。它更适合保留在英文 tool-use 研究线上。
最终选型
扩展到 10 个模型后,可选方案更完整,但默认结论没有改变:
- Qwen3.5-2B Q4_K_M 继续作为默认本地 Agent 路由模型。 它仍是唯一同时达到 Parse 100%、Skill/Action 95.8%、Mode 96.9%,且 8K Metal 小于 2 GiB 的模型。
- 8 GB 设备可以默认开放 8K 容量,但正常 Prompt 应控制在 2K-4K。 接近填满的 7,680-token prefill P50 为 30.583 秒,应只在必要时使用。
- 将 LFM2.5-1.2B 和 Llama 3.2 1B 保留在 Skill-only 研究路线。 它们的资源表现优秀,但不能直接生成执行参数。
- 模型能成功加载,不等于达到生产要求。 Action、Mode、缺槽、双语一致性、热状态和恢复能力都需要独立过门槛。
限制和下一轮
3.5K/7.5K 长 prefill 和生成吞吐已经补测;下一轮还需要使用自然多文档内容验证长上下文准确率,并增加 20 轮持续会话、电量下降、完整热曲线和 Jetsam 恢复。Gemma 3n E2B、MiniCPM-V 等多模态候选,则需要针对屏幕理解、OCR、图片和隐私边界建立独立 VLM 协议。
更重要的结论是:手机本地模型选型是一个系统工程问题。模型大小很重要,但 prompt 协议、结构化可靠性、context 内存、语言一致性、发热,以及 Runtime 的确定性保护同样重要。