
私たちは、単純に見える問いにより厳密な答えを出そうとしました。実用的なローカルエージェントをスマートフォン上で動かすには、どの小型言語モデルが本当に適しているのでしょうか。
最初の比較では 5 つの小型 GGUF モデルを測定しました。今回は Llama 3.2 1B/3B、SmolLM2 1.7B/SmolLM3 3B、LFM2.5 1.2B の 5 モデルを追加しました。最終的な検証規模は、10 モデル、20 のコンテキスト構成、iPhone での 60 回のロード成功、1,920 回の決定的ルーティング評価です。
リソース測定は iPhone 15 Pro Max 実機で行いました。全モデルを GGUF Q4_K_M、Metal 全レイヤーオフロードに統一し、4K と 8K の両方を測定しました。能力評価では、中国語と英語の同じ 96 件のエージェント要求を使い、構造化 Parse、Skill と Action の選択、Mode 分類、必須スロット、Planning を確認しました。
これは一般的なリーダーボードではありません。モデルがスマートフォンに収まり、すばやく応答し、リマインダーやメール下書き、メモリに触れるエージェントに対して信頼できる構造化決定を返せるかを検証するものです。
テストした 10 モデル
横にスワイプしてすべての列を表示
| モデル | 提供元 | GGUF サイズ | 量子化 |
|---|---|---|---|
| MiniCPM5-1B | OpenBMB | 656.2 MiB | Q4_K_M |
| LFM2.5-1.2B-Instruct | Liquid AI | 697.0 MiB | Q4_K_M |
| Llama 3.2 1B Instruct | Meta | 770.3 MiB | Q4_K_M |
| Gemma 3 1B IT | 768.7 MiB | Q4_K_M | |
| SmolLM2-1.7B-Instruct | Hugging Face | 1006.7 MiB | Q4_K_M |
| Qwen3.5-2B | Qwen | 1221.5 MiB | Q4_K_M |
| SmolLM3-3B | Hugging Face | 1826.6 MiB | Q4_K_M |
| Llama 3.2 3B Instruct | Meta | 1925.8 MiB | Q4_K_M |
| Qwen2.5-3B-Instruct | Qwen | 2007.4 MiB | Q4_K_M |
| Phi-4-mini 3.8B | Microsoft | 2376.4 MiB | Q4_K_M |
再現性を確保するため、追加した重みはリポジトリの commit、SHA-256、ライセンス、prompt profile を固定しました。Llama 3 には header-token テンプレート、SmolLM3 には /no_think、LFM2.5 には必須の start-of-text token を使っています。
メインラインが Qwen3.8 なのに、なぜ Qwen3.5 なのか
Qwen の最新メインラインはすでに 3.5 を超えていますが、公開の中心はさらに大規模なクラウドおよびワークステーション向けモデルです。8 GB のスマートフォン内に常駐する 1B-4B モデルとは、同じ導入カテゴリではありません。
今回の対象には、利用可能な 8K 容量、制御された実使用 Prompt、予測可能なメモリ、安定した構造化出力が必要です。この条件では、Qwen3.5-2B は今も有力なスマートフォンサイズの候補です。Qwen3.6、Qwen3.7、Qwen3.8 には、現時点でこの役割をそのまま置き換える明確な公式オープン 1B/2B クラスがありません。
テストプロトコル
横にスワイプして図全体を表示
図を生成できませんでした。下でソースを確認できます。
図のソースを表示
flowchart LR
    A[モデル commit と SHA-256 を固定] --> B[ネイティブ Prompt Profile を適用]
    B --> C[iPhone で 4K と 8K を実行]
    C --> D[Load TTFT プロセス Metal メモリを記録]
    D --> E[同じ 96 件の二言語ルーティングを実行]
    E --> F[リソースと能力のゲートを適用]
実機は iPhone 15 Pro Max、A17 Pro、8 GB 物理メモリ、iOS 26.6.1、SwiftLlama、llama.cpp b8668 です。各モデルと context の組み合わせを独立して 3 回起動し、60 回すべてでロードに成功しました。
実機では短い prompt を使ったため、数値はモデルロード、context 確保、短い prompt の TTFT、基本生成、メモリ使用量を示します。4K/8K を埋める長文 prefill のストレステストではありません。96 件の能力評価は同じモデルファイルと決定的設定を使い、比較の再現性を保つためデスクトップ Metal evaluator で実行しました。
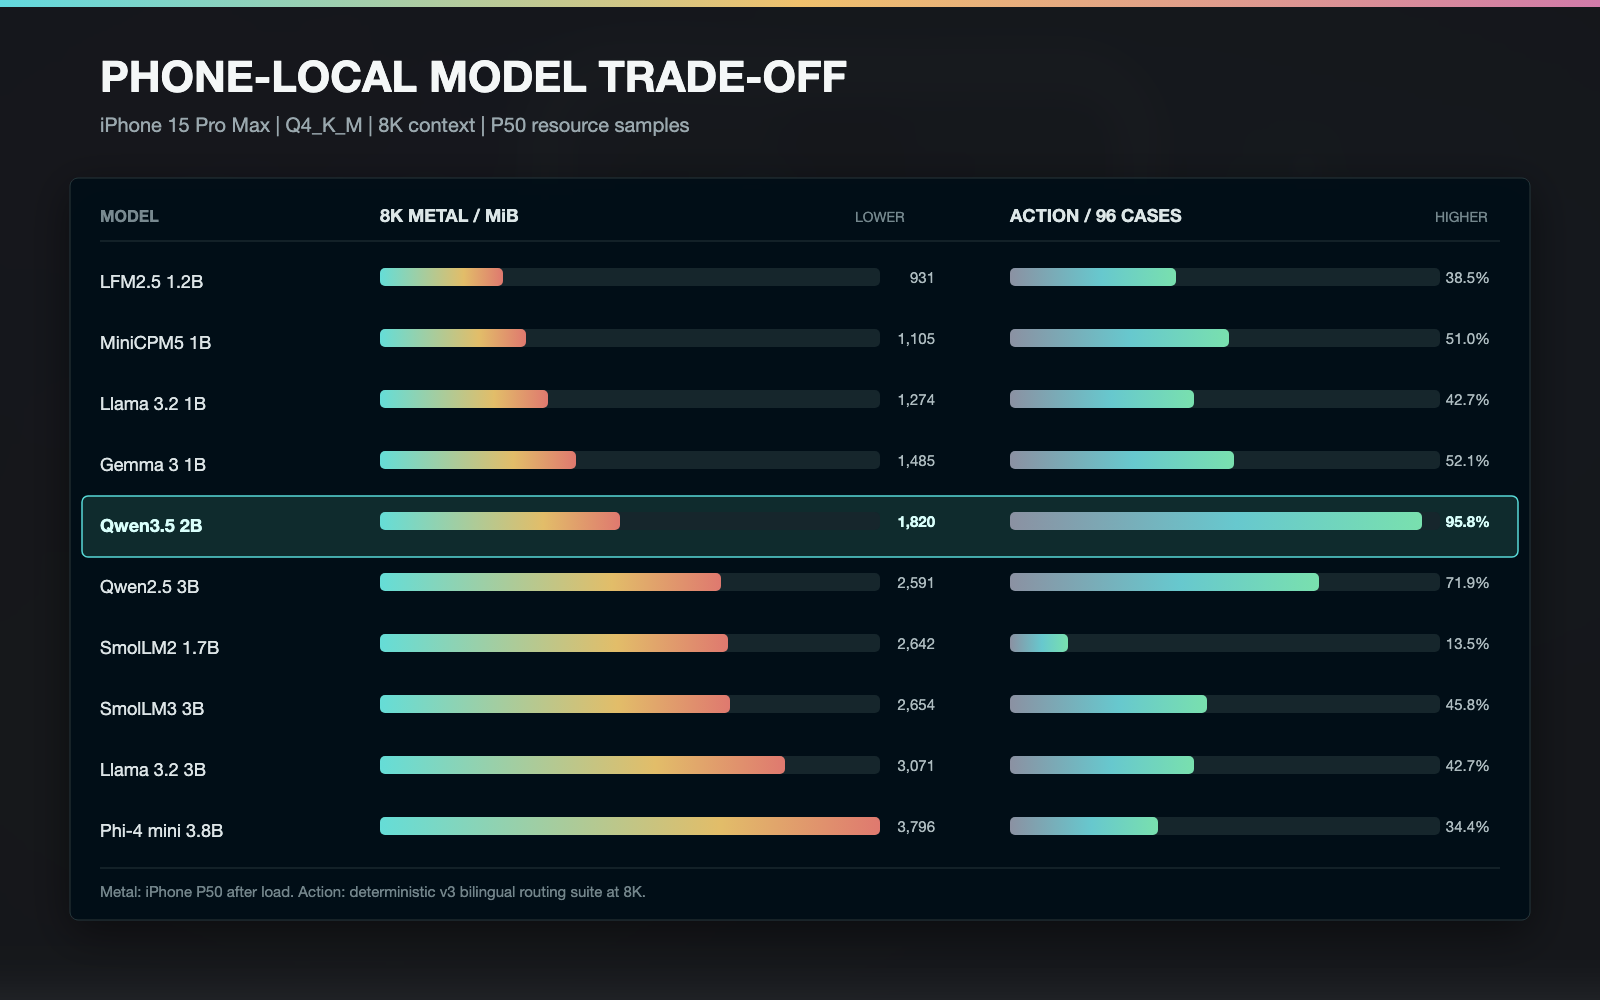
iPhone 15 Pro Max の 4K/8K リソース結果
数値は 3 回の独立起動における P50 です。組になった値は 4K / 8K の順です。
横にスワイプしてすべての列を表示
| モデル | Load | TTFT | プロセスメモリ | Metal メモリ | Thermal |
|---|---|---|---|---|---|
| MiniCPM5-1B | 0.172 / 0.176 s | 0.140 / 0.136 s | 175.7 / 271.6 MiB | 1008.8 / 1104.8 MiB | Fair |
| Gemma 3 1B IT | 0.621 / 0.567 s | 0.215 / 0.200 s | 197.3 / 301.3 MiB | 1381.2 / 1485.2 MiB | Nominal |
| LFM2.5-1.2B | 0.132 / 0.131 s | 0.188 / 0.181 s | 110.5 / 158.2 MiB | 899.4 / 931.4 MiB | Nominal |
| Llama 3.2 1B | 0.228 / 0.237 s | 0.164 / 0.167 s | 228.8 / 356.8 MiB | 1145.8 / 1273.8 MiB | Fair |
| SmolLM2-1.7B | 0.188 / 0.253 s | 0.265 / 0.257 s | 823.4 / 1591.9 MiB | 1873.5 / 2641.5 MiB | Fair |
| Qwen3.5-2B | 0.323 / 0.323 s | 0.268 / 0.274 s | 201.4 / 249.6 MiB | 1767.8 / 1819.8 MiB | Fair |
| Qwen2.5-3B | 0.303 / 0.296 s | 0.445 / 0.442 s | 230.8 / 375.0 MiB | 2447.0 / 2591.0 MiB | Fair |
| Llama 3.2 3B | 0.319 / 0.374 s | 0.429 / 0.435 s | 550.2 / 999.0 MiB | 2623.3 / 3071.3 MiB | Serious |
| SmolLM3-3B | 0.293 / 0.314 s | 0.435 / 0.433 s | 390.8 / 679.2 MiB | 2366.1 / 2654.1 MiB | Nominal / Fair |
| Phi-4-mini 3.8B | 0.431 / 0.569 s | 0.503 / 0.511 s | 614.0 / 1126.4 MiB | 3291.8 / 3795.8 MiB | Nominal |
リソース面の勝者は LFM2.5 で、8K の Metal 割り当ては 931.4 MiB でした。Qwen3.5-2B は 4K から 8K に上げても Metal メモリが 52 MiB しか増えていません。SmolLM2 の増分は 768 MiB、Llama 3.2 3B は実機 6 サンプルすべてで Serious の熱状態に達しました。
Prompt を実際にほぼ埋めるとどうなるか
上の 0.274 秒は 85-token の短い Prompt に対する TTFT です。8K の内容を 0.274 秒で処理できるという意味ではありません。そこで、最終候補の Qwen3.5-2B に対して、ほぼ満杯の context を使う追加テストを行いました。
モデルのロード後、アプリ自身の tokenizer でレンダリング済み Prompt を正確に 3,584 と 7,680 tokens に調整し、出力用に 512 tokens を残しました。各条件を独立した 3 回の交互起動で測定し、起動間に 30 秒冷却し、prefill 後に 63 tokens を生成しました。表は llama.cpp のネイティブ計測による P50 です。
横にスワイプしてすべての列を表示
| Context | 実 Prompt | Prefill | Prefill 速度 | TTFT | 63-token 合計 | Decode | 生成後 Metal | Thermal |
|---|---|---|---|---|---|---|---|---|
| 4K | 3,584 tokens | 13.375s | 268.0 tok/s | 13.385s | 16.570s | 19.9 tok/s | 1769.4 MiB | Fair 1 / Serious 2 |
| 8K | 7,680 tokens | 30.583s | 251.1 tok/s | 30.602s | 33.868s | 19.7 tok/s | 1821.4 MiB | Serious 3 |
ここでは 2 種類のコストを分けて考える必要があります。8K 容量を利用可能にするコストは小さく、 静的な Metal 割り当ては 52 MiB 増えるだけで、モデルファイルも大きくなりません。実際に 7,680 tokens まで埋めるコストは小さくありません。 P50 prefill は 3,584 tokens の 2.29 倍で、3 回すべて Serious の熱状態で終了しました。
したがって、8 GB 端末では 8K context 上限をデフォルトで利用可能にできますが、Runtime は通常の実使用 Prompt を 2K-4K 程度に抑えるべきです。履歴、検索結果、Tool 出力を 8K 近くまで広げるのは、その待ち時間に見合うタスクだけに限定します。
追加測定の完全な手順、時間範囲、熱状態の解釈、Runtime ポリシーは、「Qwen3.5-2B 選定後の実測:iPhone の 4K と 8K は何が違うか」にまとめています。
96 件のエージェント能力評価
データセットは 12 の Skill を対象に、中国語 48 件、英語 48 件、core と challenge を各 48 件含みます。Parse は完全な 2 段階プロトコルの成功率で、全指標を 96 件すべてに対して計算しています。組になった値は 4K / 8K です。
横にスワイプしてすべての列を表示
| モデル | Parse | Skill | Action | Mode | 4K E2E P50 |
|---|---|---|---|---|---|
| MiniCPM5-1B | 62.5 / 62.5% | 85.4 / 85.4% | 51.0 / 51.0% | 53.1 / 53.1% | 0.622 s |
| Gemma 3 1B IT | 68.8 / 68.8% | 82.3 / 82.3% | 52.1 / 52.1% | 58.3 / 58.3% | 0.976 s |
| LFM2.5-1.2B | 56.2 / 56.2% | 80.2 / 80.2% | 38.5 / 38.5% | 44.8 / 44.8% | 0.903 s |
| Llama 3.2 1B | 53.1 / 53.1% | 86.5 / 86.5% | 42.7 / 42.7% | 46.9 / 46.9% | 1.401 s |
| SmolLM2-1.7B | 69.8 / 69.8% | 21.9 / 21.9% | 13.5 / 13.5% | 31.2 / 31.2% | 2.319 s |
| Qwen3.5-2B | 100 / 100% | 95.8 / 95.8% | 95.8 / 95.8% | 96.9 / 96.9% | 1.098 s |
| Qwen2.5-3B | 94.8 / 94.8% | 80.2 / 80.2% | 71.9 / 71.9% | 79.2 / 79.2% | 1.633 s |
| Llama 3.2 3B | 94.8 / 94.8% | 51.0 / 51.0% | 42.7 / 42.7% | 61.5 / 61.5% | 1.644 s |
| SmolLM3-3B | 76.0 / 76.0% | 56.2 / 56.2% | 45.8 / 45.8% | 49.0 / 49.0% | 2.015 s |
| Phi-4-mini 3.8B | 67.7 / 63.5% | 50.0 / 55.2% | 42.7 / 34.4% | 51.0 / 42.7% | 2.220 s |
短いルーティング要求は 4K に十分収まるため、追加候補の精度は 8K で自動的に向上しませんでした。ここで 8K が検証するのは導入コストと容量の互換性であり、知能の増加ではありません。
追加モデルから得られた新しい結論
LFM2.5-1.2B は追加モデルで最も優れたリソース候補です。 実機で最も軽く、Skill 精度は 80.2% でした。ただし Action は 38.5% にとどまり、完全な実行を安全に任せられません。低リスクな第 1 段階の Skill 絞り込みモデルとして研究する価値があります。
Llama 3.2 1B は追加モデル中で最高の 86.5% Skill を記録しました。 一方で Parse 53.1%、Action 42.7% です。意図の認識は、完全な実行契約を生成するよりはるかに簡単だという境界が明確です。ライセンス確認を前提に、Skill-only の研究候補です。
Llama 3.2 3B は形式を守れても、意味の選択を誤りました。 Parse は 94.8% ですが Skill は 51.0% です。8K で 3071.3 MiB の Metal メモリを使い、Serious の熱状態にも繰り返し達しました。
SmolLM2-1.7B は現在の二言語ルーティングに適合しません。 Skill 21.9%、Action 13.5% は最下位で、8K context のコストも異常に高い結果でした。
SmolLM3-3B は SmolLM2 より大きく改善しましたが、Skill 56.2%、Action 45.8% は実行基準に届きません。英語中心の tool-use 研究に残すほうが適しています。
最終判断
10 モデルへ比較を広げたことで選択肢は増えましたが、デフォルトの結論は変わりません。
- Qwen3.5-2B Q4_K_M をデフォルトのローカルエージェントルーターとします。 Parse 100%、Skill/Action 95.8%、Mode 96.9%、8K Metal 2 GiB 未満を同時に満たす唯一のモデルです。
- 8 GB 端末では 8K 容量をデフォルトで利用可能にし、通常の Prompt は 2K-4K に抑えます。 ほぼ満杯の 7,680-token Prompt は P50 で 30.583 秒かかるため、必要なタスクだけに使います。
- LFM2.5-1.2B と Llama 3.2 1B は Skill-only の研究ラインに残します。 リソース特性は優秀ですが、実行パラメータを直接生成させるべきではありません。
- ロード成功を本番対応と同一視しません。 Action、Mode、必須スロット、二言語の一貫性、熱、復旧動作はそれぞれ別のゲートです。
制限と次のテスト
3.5K/7.5K の長文 prefill と生成 throughput の追加測定は完了しました。次回は自然な複数文書での長文精度、20 ターンの連続セッション、バッテリー低下、完全な熱推移、Jetsam 復旧が必要です。Gemma 3n E2B や MiniCPM-V などのマルチモーダル候補には、画面理解、OCR、画像、プライバシー境界を扱う独立した vision-language プロトコルが必要です。
最も重要な教訓は、スマートフォン上のローカルモデル選定がシステム全体の問題だということです。モデルサイズだけでなく、prompt protocol、構造化信頼性、context メモリ、言語の一貫性、発熱、Runtime の決定的な保護機構も同じように重要です。