
우리는 단순해 보이는 질문에 더 엄격한 답을 내리고자 했습니다. 스마트폰에서 유용한 로컬 에이전트를 구동하기에 실제로 적합한 소형 언어 모델은 무엇일까요?
첫 비교에서는 소형 GGUF 모델 5개를 측정했습니다. 이번에는 Llama 3.2 1B/3B, SmolLM2 1.7B/SmolLM3 3B, LFM2.5 1.2B 등 5개 모델을 추가했습니다. 완성된 실험은 10개 모델, 20개 컨텍스트 구성, 60회의 성공적인 iPhone 독립 실행, 1,920회의 결정적 라우팅 평가로 구성됩니다.
리소스 테스트는 iPhone 15 Pro Max 실제 기기에서 실행했습니다. 모든 모델에 GGUF Q4_K_M, Metal 전체 레이어 오프로딩, 4K/8K context를 동일하게 적용했습니다. 능력 평가는 동일한 중국어 및 영어 에이전트 요청 96개를 사용해 구조화 Parse, Skill/Action 선택, Mode 분류, 필수 슬롯, Planning을 확인했습니다.
이 글은 일반적인 리더보드가 아닙니다. 모델이 스마트폰에 들어가고 빠르게 응답하며, 알림이나 이메일 초안, 메모리에 접근할 수 있는 에이전트를 위해 신뢰할 수 있는 구조화 결정을 만들 수 있는지 검증합니다.
테스트한 10개 모델
좌우로 밀어 모든 열 보기
| 모델 | 제공자 | GGUF 크기 | 양자화 |
|---|---|---|---|
| MiniCPM5-1B | OpenBMB | 656.2 MiB | Q4_K_M |
| LFM2.5-1.2B-Instruct | Liquid AI | 697.0 MiB | Q4_K_M |
| Llama 3.2 1B Instruct | Meta | 770.3 MiB | Q4_K_M |
| Gemma 3 1B IT | 768.7 MiB | Q4_K_M | |
| SmolLM2-1.7B-Instruct | Hugging Face | 1006.7 MiB | Q4_K_M |
| Qwen3.5-2B | Qwen | 1221.5 MiB | Q4_K_M |
| SmolLM3-3B | Hugging Face | 1826.6 MiB | Q4_K_M |
| Llama 3.2 3B Instruct | Meta | 1925.8 MiB | Q4_K_M |
| Qwen2.5-3B-Instruct | Qwen | 2007.4 MiB | Q4_K_M |
| Phi-4-mini 3.8B | Microsoft | 2376.4 MiB | Q4_K_M |
재현성을 위해 추가 가중치마다 저장소 commit, SHA-256, 라이선스, prompt profile을 고정했습니다. Llama 3에는 header-token 템플릿을 사용했고, SmolLM3에는 /no_think를 명시했으며, LFM2.5에는 필수 start-of-text token을 적용했습니다.
메인라인이 Qwen3.8인데 왜 Qwen3.5를 테스트했을까
Qwen의 최신 메인라인은 이미 3.5를 넘어섰지만, 공개된 중심 모델은 훨씬 큰 클라우드 및 워크스테이션급입니다. 이들은 8 GB 스마트폰에 상주해야 하는 1B-4B 모델과 같은 배포 범주가 아닙니다.
우리의 목표에는 사용할 수 있는 8K 용량, 제어된 활성 Prompt, 예측 가능한 메모리, 안정적인 구조화 출력이 필요합니다. 이 조건에서 Qwen3.5-2B는 여전히 중요한 스마트폰 크기 후보입니다. Qwen3.6, Qwen3.7, Qwen3.8에는 현재 이 역할을 그대로 대체할 명확한 공식 오픈 1B/2B급 모델이 없습니다.
테스트 프로토콜
좌우로 밀어 전체 다이어그램 보기
다이어그램을 생성하지 못했습니다. 아래에서 원본을 볼 수 있습니다.
다이어그램 원본 보기
flowchart LR
    A[모델 commit과 SHA-256 고정] --> B[네이티브 Prompt Profile 적용]
    B --> C[iPhone에서 4K와 8K 실행]
    C --> D[Load TTFT 프로세스 Metal 메모리 기록]
    D --> E[동일한 96개 이중언어 라우팅 실행]
    E --> F[리소스와 능력 게이트 적용]
기기는 iPhone 15 Pro Max, A17 Pro, 8 GB 물리 메모리, iOS 26.6.1, SwiftLlama, llama.cpp b8668입니다. 각 모델/context 조합을 독립적으로 3회 실행했으며 60회 모두 로드에 성공했습니다.
기기 테스트에는 짧은 prompt를 사용했으므로 수치는 모델 로딩, context 할당, 짧은 prompt TTFT, 기본 생성, 메모리 사용량을 보여 줍니다. 4K/8K를 채우는 긴 prefill 스트레스 테스트는 아닙니다. 96개 능력 평가는 동일한 모델 파일과 결정적 설정을 사용했으며, 비교 재현성을 위해 데스크톱 Metal evaluator에서 실행했습니다.
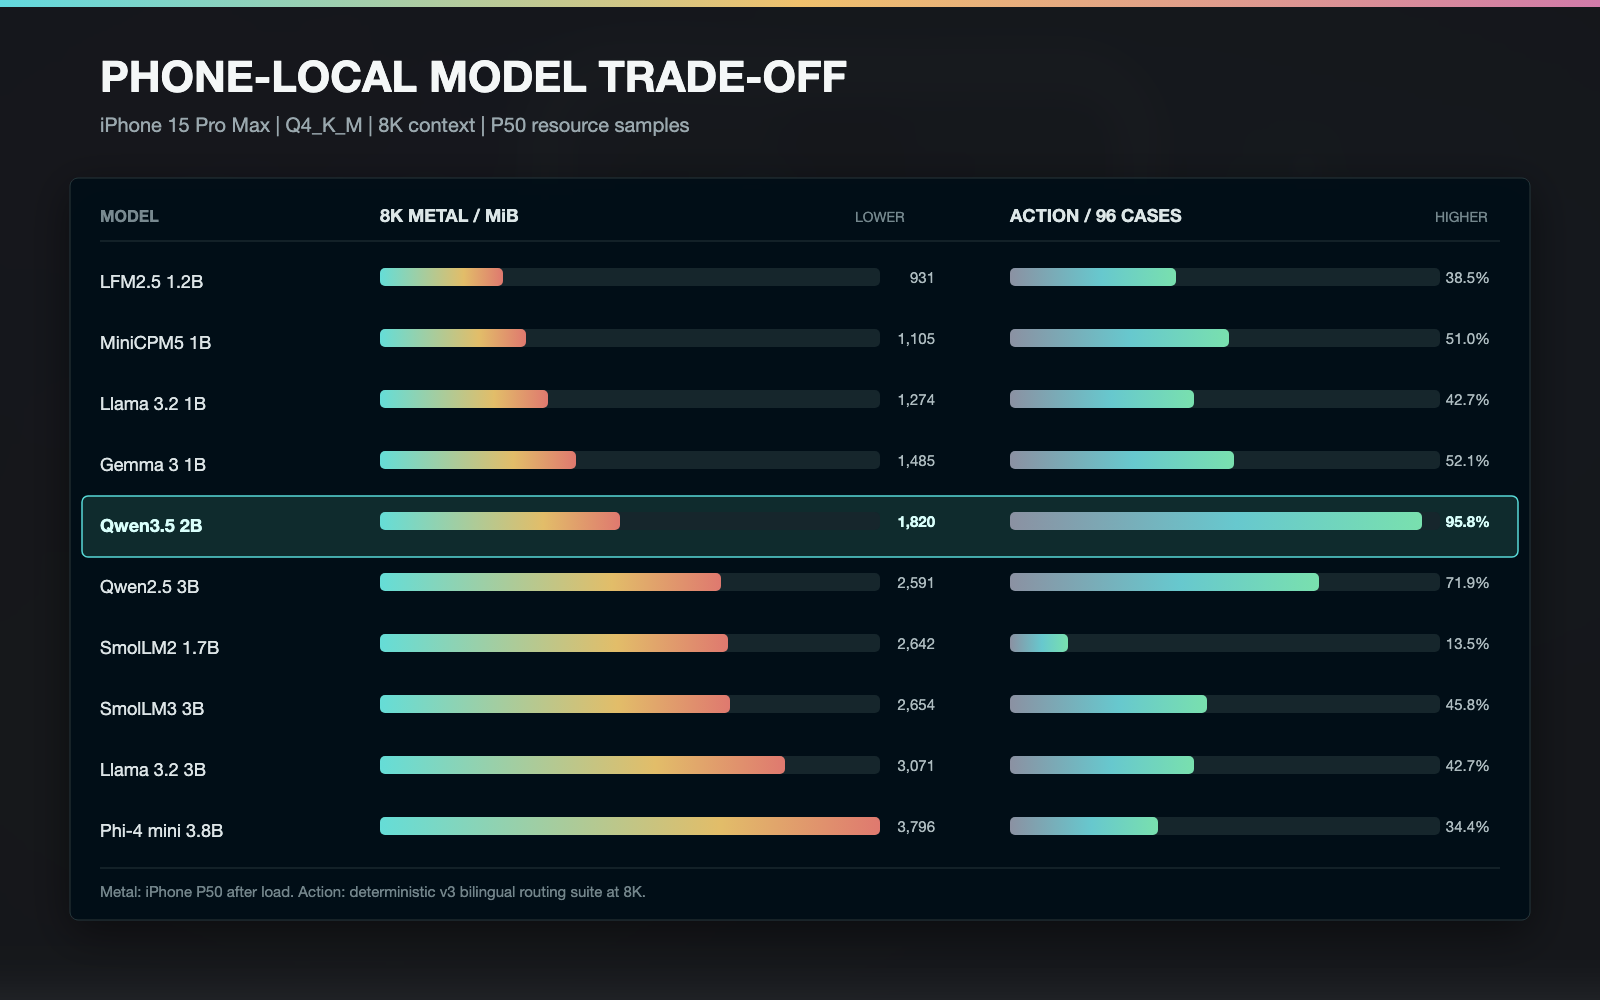
iPhone 15 Pro Max의 4K/8K 리소스 결과
수치는 세 번의 독립 실행에서 얻은 P50입니다. 쌍으로 표시된 값은 4K / 8K 순서입니다.
좌우로 밀어 모든 열 보기
| 모델 | Load | TTFT | 프로세스 메모리 | Metal 메모리 | Thermal |
|---|---|---|---|---|---|
| MiniCPM5-1B | 0.172 / 0.176 s | 0.140 / 0.136 s | 175.7 / 271.6 MiB | 1008.8 / 1104.8 MiB | Fair |
| Gemma 3 1B IT | 0.621 / 0.567 s | 0.215 / 0.200 s | 197.3 / 301.3 MiB | 1381.2 / 1485.2 MiB | Nominal |
| LFM2.5-1.2B | 0.132 / 0.131 s | 0.188 / 0.181 s | 110.5 / 158.2 MiB | 899.4 / 931.4 MiB | Nominal |
| Llama 3.2 1B | 0.228 / 0.237 s | 0.164 / 0.167 s | 228.8 / 356.8 MiB | 1145.8 / 1273.8 MiB | Fair |
| SmolLM2-1.7B | 0.188 / 0.253 s | 0.265 / 0.257 s | 823.4 / 1591.9 MiB | 1873.5 / 2641.5 MiB | Fair |
| Qwen3.5-2B | 0.323 / 0.323 s | 0.268 / 0.274 s | 201.4 / 249.6 MiB | 1767.8 / 1819.8 MiB | Fair |
| Qwen2.5-3B | 0.303 / 0.296 s | 0.445 / 0.442 s | 230.8 / 375.0 MiB | 2447.0 / 2591.0 MiB | Fair |
| Llama 3.2 3B | 0.319 / 0.374 s | 0.429 / 0.435 s | 550.2 / 999.0 MiB | 2623.3 / 3071.3 MiB | Serious |
| SmolLM3-3B | 0.293 / 0.314 s | 0.435 / 0.433 s | 390.8 / 679.2 MiB | 2366.1 / 2654.1 MiB | Nominal / Fair |
| Phi-4-mini 3.8B | 0.431 / 0.569 s | 0.503 / 0.511 s | 614.0 / 1126.4 MiB | 3291.8 / 3795.8 MiB | Nominal |
리소스 부문 승자는 LFM2.5로, 8K Metal 할당이 931.4 MiB에 그쳤습니다. Qwen3.5-2B는 4K에서 8K로 올릴 때 Metal 메모리가 52 MiB만 증가했습니다. SmolLM2는 768 MiB가 증가했고, Llama 3.2 3B는 실제 기기 샘플 6회 모두에서 Serious 열 상태에 도달했습니다.
Prompt를 실제로 거의 채우면
위의 0.274초는 85-token 짧은 Prompt의 TTFT입니다. 8K 내용을 0.274초 만에 처리한다는 의미는 아닙니다. 이를 확인하기 위해 최종 후보 Qwen3.5-2B로 context를 거의 채운 추가 테스트를 진행했습니다.
모델을 로드한 뒤 앱 자체 tokenizer로 렌더링된 Prompt를 정확히 3,584와 7,680 tokens로 맞추고 출력용 512 tokens를 남겼습니다. 각 조건은 독립 실행 3회, 교차 순서, 실행 사이 30초 냉각으로 측정했으며 prefill 뒤 63 tokens를 생성했습니다. 표는 llama.cpp 네이티브 성능 카운터의 P50입니다.
좌우로 밀어 모든 열 보기
| Context | 실제 Prompt | Prefill | Prefill 속도 | TTFT | 63-token 총시간 | Decode | 생성 후 Metal | Thermal |
|---|---|---|---|---|---|---|---|---|
| 4K | 3,584 tokens | 13.375s | 268.0 tok/s | 13.385s | 16.570s | 19.9 tok/s | 1769.4 MiB | Fair 1 / Serious 2 |
| 8K | 7,680 tokens | 30.583s | 251.1 tok/s | 30.602s | 33.868s | 19.7 tok/s | 1821.4 MiB | Serious 3 |
두 비용은 분리해서 봐야 합니다. 8K 용량을 열어 두는 비용은 작습니다. 정적 Metal 할당은 52 MiB만 늘고 모델 파일 크기는 변하지 않습니다. 실제로 7,680 tokens까지 채우는 비용은 작지 않습니다. P50 prefill은 3,584 tokens의 2.29배였고 세 번 모두 Serious 열 상태로 끝났습니다.
따라서 8 GB 기기에서는 8K context 상한을 기본으로 사용할 수 있지만, Runtime의 일반 활성 Prompt는 2K-4K 수준으로 유지해야 합니다. 대화 기록, 검색 근거, Tool 출력은 지연을 감수할 가치가 있는 작업에서만 8K에 가깝게 확장합니다.
추가 측정의 전체 절차, 시간 범위, 열 상태 해석, Runtime 정책은 Qwen3.5-2B 선택 후 검증: iPhone에서 4K와 8K의 실제 비용에 정리했습니다.
96개 에이전트 능력 평가
데이터셋은 12개 Skill을 대상으로 중국어 48개, 영어 48개, core/challenge 각 48개를 포함합니다. Parse는 전체 2단계 프로토콜 성공률이며 모든 점수는 전체 96개 사례를 기준으로 계산했습니다. 쌍으로 표시된 값은 4K / 8K입니다.
좌우로 밀어 모든 열 보기
| 모델 | Parse | Skill | Action | Mode | 4K E2E P50 |
|---|---|---|---|---|---|
| MiniCPM5-1B | 62.5 / 62.5% | 85.4 / 85.4% | 51.0 / 51.0% | 53.1 / 53.1% | 0.622 s |
| Gemma 3 1B IT | 68.8 / 68.8% | 82.3 / 82.3% | 52.1 / 52.1% | 58.3 / 58.3% | 0.976 s |
| LFM2.5-1.2B | 56.2 / 56.2% | 80.2 / 80.2% | 38.5 / 38.5% | 44.8 / 44.8% | 0.903 s |
| Llama 3.2 1B | 53.1 / 53.1% | 86.5 / 86.5% | 42.7 / 42.7% | 46.9 / 46.9% | 1.401 s |
| SmolLM2-1.7B | 69.8 / 69.8% | 21.9 / 21.9% | 13.5 / 13.5% | 31.2 / 31.2% | 2.319 s |
| Qwen3.5-2B | 100 / 100% | 95.8 / 95.8% | 95.8 / 95.8% | 96.9 / 96.9% | 1.098 s |
| Qwen2.5-3B | 94.8 / 94.8% | 80.2 / 80.2% | 71.9 / 71.9% | 79.2 / 79.2% | 1.633 s |
| Llama 3.2 3B | 94.8 / 94.8% | 51.0 / 51.0% | 42.7 / 42.7% | 61.5 / 61.5% | 1.644 s |
| SmolLM3-3B | 76.0 / 76.0% | 56.2 / 56.2% | 45.8 / 45.8% | 49.0 / 49.0% | 2.015 s |
| Phi-4-mini 3.8B | 67.7 / 63.5% | 50.0 / 55.2% | 42.7 / 34.4% | 51.0 / 42.7% | 2.220 s |
짧은 라우팅 요청은 4K 안에 충분히 들어가기 때문에 추가 후보의 정확도가 8K에서 자동으로 높아지지는 않았습니다. 여기서 8K는 배포 비용과 용량 호환성을 검증하며, 지능을 추가하는 설정은 아닙니다.
추가 모델에서 얻은 결론
LFM2.5-1.2B는 가장 강력한 신규 리소스 후보입니다. 실제 기기에서 가장 가벼웠고 Skill 정확도는 80.2%였습니다. 하지만 Action 정확도 38.5%로는 전체 실행을 안전하게 맡길 수 없습니다. 저위험 1단계 Skill 후보 축소 모델로 연구할 가치가 있습니다.
Llama 3.2 1B는 신규 모델 중 가장 높은 86.5% Skill을 기록했습니다. 그러나 Parse 53.1%, Action 42.7%는 명확한 경계를 보여 줍니다. 의도를 알아내는 일은 완전한 실행 계약을 만드는 것보다 훨씬 쉽습니다. 라이선스 검토를 전제로 Skill-only 연구 후보입니다.
Llama 3.2 3B는 유효한 형식을 만들었지만 의미 선택을 자주 틀렸습니다. Parse는 94.8%였지만 Skill은 51.0%였습니다. 8K에서 Metal 메모리 3071.3 MiB를 사용했고 Serious 열 상태에도 반복적으로 도달했습니다.
SmolLM2-1.7B는 현재 이중언어 라우팅 작업과 맞지 않습니다. Skill 21.9%, Action 13.5%로 가장 낮았고 8K context 비용도 비정상적으로 컸습니다.
SmolLM3-3B는 SmolLM2보다 크게 개선됐지만, Skill 56.2%, Action 45.8%로 실행 기준에는 미치지 못했습니다. 영어 중심 tool-use 연구에 남기는 편이 적절합니다.
최종 결정
비교 범위를 10개 모델로 넓혀 선택지는 많아졌지만 기본 결론은 바뀌지 않았습니다.
- Qwen3.5-2B Q4_K_M을 기본 로컬 에이전트 라우터로 유지합니다. Parse 100%, Skill/Action 95.8%, Mode 96.9%, 8K Metal 2 GiB 미만을 동시에 만족하는 유일한 모델입니다.
- 8 GB 기기에서는 8K 용량을 기본으로 열어 두되 일반 Prompt는 2K-4K로 유지합니다. 거의 가득 찬 7,680-token Prompt는 P50 30.583초가 필요하므로 필요한 작업에만 사용합니다.
- LFM2.5-1.2B와 Llama 3.2 1B는 Skill-only 연구 트랙에 유지합니다. 리소스 특성은 뛰어나지만 실행 파라미터를 직접 생성하게 해서는 안 됩니다.
- 로드 성공을 프로덕션 준비 완료로 간주하지 않습니다. Action, Mode, 필수 슬롯, 이중언어 일관성, 발열, 복구 동작은 각각 별도의 게이트입니다.
한계와 다음 테스트
3.5K/7.5K 긴 prefill과 생성 throughput 추가 측정은 완료했습니다. 다음 평가에는 자연스러운 여러 문서의 긴 context 정확도, 20턴 연속 세션, 배터리 감소, 전체 열 곡선, Jetsam 복구가 필요합니다. Gemma 3n E2B, MiniCPM-V 같은 멀티모달 후보에는 화면 이해, OCR, 이미지, 개인정보 경계를 다루는 별도의 vision-language 프로토콜이 필요합니다.
더 큰 교훈은 스마트폰 로컬 모델 선택이 시스템 전체의 문제라는 점입니다. 모델 크기뿐 아니라 prompt protocol, 구조화 신뢰성, context 메모리, 언어 일관성, 발열, Runtime의 결정적 보호 장치도 똑같이 중요합니다.